


KI-gestützte Ergebnisanalyse
Der Analyst-Agent in Balansor bewertet eine abgeschlossene Kampagne unter zwei Gesichtspunkten und fasst beide zu einem Gesamturteil zusammen:
- Statistische Datenqualität – Repräsentativität der Stichprobe (entspricht die Stichprobe der Zielpopulation?) und Antwortqualität (liefern die Fragen aussagekräftige, vielfältige Antworten?).
- Beantwortbarkeit der Forschungsziele – beantworten die erhobenen Daten tatsächlich die Forschungsfragen, KPIs und Erfolgskriterien, die im Forschungsbericht des Projekts festgehalten sind? Damit schließt sich die Kette Ziel → KPI → Frage, die beim Entwurf des Fragebogens angelegt wurde: Jedes Forschungsziel benennt einen KPI und dessen Messung, und der Analyst prüft, ob die dafür erhobenen Daten für eine Schlussfolgerung ausreichen.
Den ersten Gesichtspunkt übergibt der Analyst an einen Sub-Agenten Quality Analyst, den zweiten an einen Sub-Agenten Research Evaluator. Beide Ergebnisse fasst er anschließend zu einem strukturierten Bericht mit umsetzbaren Empfehlungen zusammen.
Überblick
Abschnitt betitelt „Überblick“Nach der Erhebung der Antworten müssen Forschende zwei grundlegende Fragen klären, bevor sie ihren Daten vertrauen können:
- Ist die Stichprobe repräsentativ? – Entspricht die Demografie der Befragten der Zielpopulation, die in der Stichprobenstrategie festgelegt ist?
- Sind die Antworten verlässlich? – Zeigen die Antwortmuster, dass sich die Befragten ernsthaft mit den Fragen befasst haben, oder gibt es Anzeichen für Satisficing, Unaufmerksamkeit oder Verzerrungen?
Balansor beantwortet beide Fragen mit berechneten Kennzahlen und dem Analyst-Agenten, der die Ergebnisse methodisch einordnet.
Qualitätskennzahlen
Abschnitt betitelt „Qualitätskennzahlen“Die Plattform berechnet Qualitätskennzahlen in zwei Dimensionen, gestützt auf etablierte Umfragemethodik (Groves, Kish, Krosnick, Shannon, Cronbach):
| Dimension | Wichtigste Kennzahlen |
|---|---|
| Repräsentativität der Stichprobe | RMSE, MAE, Chi-Quadrat, maximale Abweichung, zusammengesetzter Qualitätswert |
| Gewichtungsdiagnostik | Designeffekt (DEFF), effektive Stichprobengröße, Variationskoeffizient der Gewichte, Abschlussquote |
| Antwortqualität | Normierte Entropie, Straightlining-Wert, Cronbachs Alpha, Zustimmungstendenz, Speeder-Erkennung, Aggregation mehrfacher Auffälligkeiten |
Vollständige Definitionen, mathematische Formeln, Interpretationsschwellen und empfohlene Maßnahmen finden Sie in der Referenz der Qualitätskennzahlen.
Der Analyst-Agent
Abschnitt betitelt „Der Analyst-Agent“Der Analyst-Agent ordnet die Qualitätskennzahlen methodisch ein, gleicht die Ergebnisse mit dem Forschungsbericht ab und erstellt daraus einen strukturierten Bericht. Er läuft als Hintergrundaufgabe in Balansor, gestützt auf das Agenten-Framework askalot_ai: Der übergeordnete Analyst steuert einen Sub-Agenten Quality Analyst (statistische Datenqualität) und einen Sub-Agenten Research Evaluator (Beantwortbarkeit der Forschungsziele über die schreibgeschützte Beantwortbarkeitskette des Forschungsberichts); anschließend fügt ein Summarizer ihre Erkenntnisse zum fertigen Bericht zusammen.
Funktionsweise
Abschnitt betitelt „Funktionsweise“- Auflösung der Zugangsdaten: Der Agent ermittelt die Zugangsdaten des KI-Anbieters aus den Benutzereinstellungen, der Organisationskonfiguration oder Umgebungsvariablen (in dieser Rangfolge)
- Datenvorabruf: Alle Qualitätskennzahlen werden vor dem Start des Agenten in Python über direkte Repository- und Analyseaufrufe gesammelt. Die Sub-Agenten interpretieren so fertige Daten, statt sie erneut abzurufen
- Mehrstufige Analyse: Der Analyst führt den Ablauf
analyze-qualityaus und delegiert an die Sub-Agenten Quality Analyst und Research Evaluator. Begrenzt wird der Lauf durch ein Zeitlimit statt durch eine feste Zahl von Schritten; anbietereigenes Streaming verhindert Zeitüberschreitungen - Fortschrittsverfolgung: Redis Streams melden den Fortschritt workerübergreifend – zuverlässig auch über mehrere Gunicorn-Worker-Prozesse hinweg
- Berichterstellung: Ein eigener Summarizer-Agent fasst die Erkenntnisse der Sub-Agenten zu einem strukturierten Markdown-Bericht zusammen
Agentenprofil
Abschnitt betitelt „Agentenprofil“| Eigenschaft | Wert |
|---|---|
| Ablauf | analyze-quality |
| Sub-Agenten | Quality Analyst, Research Evaluator |
| Modellstufe | Hoch (Claude Opus) |
| Laufzeitgrenze | Zeitlimit (mehrstufig – mit Spielraum für beide Delegationen an Sub-Agenten und die Zusammenführung) |
| Wissensbasis | Bewertung der Datenqualität, Gewichtungsmethodik, Kennzahlen zur Antwortqualität, Beantwortbarkeit der Forschungsziele |
Der Skill des Analysten enthält methodisches Fachwissen aus den AAPOR-Standards, Kish (1965), Groves et al. (2009), Kalton & Flores-Cervantes (2003), Krosnick (1991) und den ESOMAR-Richtlinien – einschließlich konkreter Formeln, Schwellenwerte und Entscheidungsregeln, um Designeffekte, Straightlining-Werte, Speeder-Markierungen und die Aggregation mehrfacher Auffälligkeiten zu interpretieren.
Aufbau des Berichts
Abschnitt betitelt „Aufbau des Berichts“Der Analyst erstellt einen Bericht mit fünf Abschnitten:
1. Zusammenfassung 2–3 Sätze: Gesamtbewertung der Qualität, Eignung für den Zweck und die wichtigste Empfehlung.
2. Repräsentativität der Stichprobe
- Gesamtqualitätswert mit Einordnung
- RMSE- und MAE-Werte mit Kontext
- Analyse pro Faktor: Welche demografischen Merkmale treffen die Ziele, welche weichen ab?
- Konkrete Zahlen: „Die Altersgruppe 18–24 ist um 8 Prozentpunkte überrepräsentiert (32 % Ist gegenüber 24 % Ziel)“
- Benchmarks: Jedes Kalibrierungsziel, das Sie auf Nur Benchmark gesetzt haben (eine externe Zahl, etwa ein Wahlergebnis oder der Anteil einer Antwort in einer nationalen Erhebung), erscheint als eigene Erkenntnis – mit seiner Abweichung in der ungewichteten und in der gewichteten Stichprobe, auch wenn das Bundle keine aktuelle Strategie hat
3. Bewertung der Gewichtung (falls ein Silver-Datensatz vorliegt)
- Recovery durch Raking – wie viel des gewichteten mittleren Fehlers die Gewichtung beseitigt hat, in Fehlereinheiten
- Aufschlüsselung der Recovery pro Faktor, in denselben Einheiten
- Gewichtungsdiagnostik: Interpretation von Designeffekt (DEFF), effektiver Stichprobengröße (ESS), Variationskoeffizient der Gewichte und Gewichtsverhältnis
- Hinweise auf Faktoren, die sich durch die Gewichtung verschlechtert haben
- Durch Raking erreicht für jedes per Raking angepasste Kalibrierungsziel – nur zur Erklärung der Gewichte: Der Wert zeigt, wie nahe das Raking seinem eigenen Ziel gekommen ist, und wird nie als Stichprobenqualität ausgewiesen
- Einschätzung, ob die Gewichtung wirksam war oder strukturelle Änderungen nötig sind
4. Antwortqualität
- Speeder-Erkennung: Zahl der markierten Fälle, Anteil an der Stichprobe, Median der Antwortzeit
- Straightlining: Gruppen mit hohen Werten (> 0,05)
- Item-Nonresponse: Fragen mit mehr als 5 % fehlenden Werten
- Index der Zustimmungstendenz (falls Likert-Skalen vorhanden sind)
- Cronbachs Alpha für die Reliabilität von Gruppen
- Fragen mit niedriger Entropie samt Einordnung
- Befragte mit mehreren Auffälligkeiten (Baseball-Regel) – gegebenenfalls mit Empfehlung zum Ausschluss
5. Wichtigste Erkenntnisse 3–5 konkrete, datengestützte Erkenntnisse. Jede bezieht sich auf tatsächliche Werte aus den Qualitätskennzahlen.
6. Empfehlungen 2–4 priorisierte, umsetzbare Empfehlungen. Jede nennt, was zu ändern ist, warum (mit Bezug auf eine konkrete Erkenntnis) und welche Wirkung zu erwarten ist.
Fundierung in der Umfragemethodik
Abschnitt betitelt „Fundierung in der Umfragemethodik“Geht es um Total Survey Error (TSE), Nonresponse-Bias, die Konvergenz des Rakings, Designeffekte oder Konzepte der Antwortqualität, stützt der Analyst seine Aussagen auf begutachtete Fachliteratur: Groves et al. zum Total Survey Error, Bethlehem zu Nonresponse, Heeringa zu Gewichtung und DEFF, Schouten zum adaptiven Umfragedesign, Krosnick zu Satisficing. Die Zitate nennen Publikation und Jahr, sodass Forschende die Aussage direkt prüfen können. Siehe Überblick über die KI-gestützten Funktionen → Fundierung in begutachteter Methodik.
Qualitätsanalyse in Balansor nutzen
Abschnitt betitelt „Qualitätsanalyse in Balansor nutzen“Qualitätskennzahlen ansehen
Abschnitt betitelt „Qualitätskennzahlen ansehen“Die Qualität finden Sie auf der Übersichtsseite des Bundles – klicken Sie auf dem Pipeline-Board auf den Titel eines Bundles. Die Seite zeigt den Repräsentativitätsverlauf: eine Stichprobe, verfolgt von der Designabsicht bis zum fertigen Ergebnis:
- Strategie → Pool – hat die Stichprobenziehung das Design erreicht? Ein Wert pro Pool, gemessen an der Strategie, aus der er erzeugt wurde
- Strategie → Ist – wie weit lag die realisierte Stichprobe vor der Gewichtung daneben? Gemessen an der aktuellen Strategie des Bundles, mit Aufschlüsselung pro Kampagne. Zeigt keine Strategie, bis eine zugewiesen ist
- Strategie → Gewichtet – hat die Gewichtung das Design wiederhergestellt? Gemessen an derselben Strategie, dazu der Recovery-Wert und der Designeffekt, den sie gekostet hat
- Pool → Ist – was hat die Feldphase selbst beigetragen? Bezogen auf den Pool, beantwortet also eine andere Frage als die drei obigen
- Antwortqualität – Antwortvielfalt, Straightlining, Konsistenz
Daneben enthält die Karte Analysebasis den Vollständigkeits-Schwellenwert. Der Block zu den ausgeschlossenen Fällen beschreibt, wen dieser Schwellenwert im Vergleich zu den verbliebenen Fällen entfernt hat. Die Repräsentativitätsmaße zeigen Aufschlüsselungen pro Faktor mit Ist- und Zielverteilung. Hat das Bundle keine aktuelle Strategie, bietet die Kopfzeile der Seite eine Strategieauswahl an, über die Sie eine zuweisen können.
Die vollständige Anleitung, einschließlich der beiden Bezugsbasen, finden Sie unter Datenanalyse: Qualitätsprüfungen.
Abschnitt Antwortqualität
Abschnitt betitelt „Abschnitt Antwortqualität“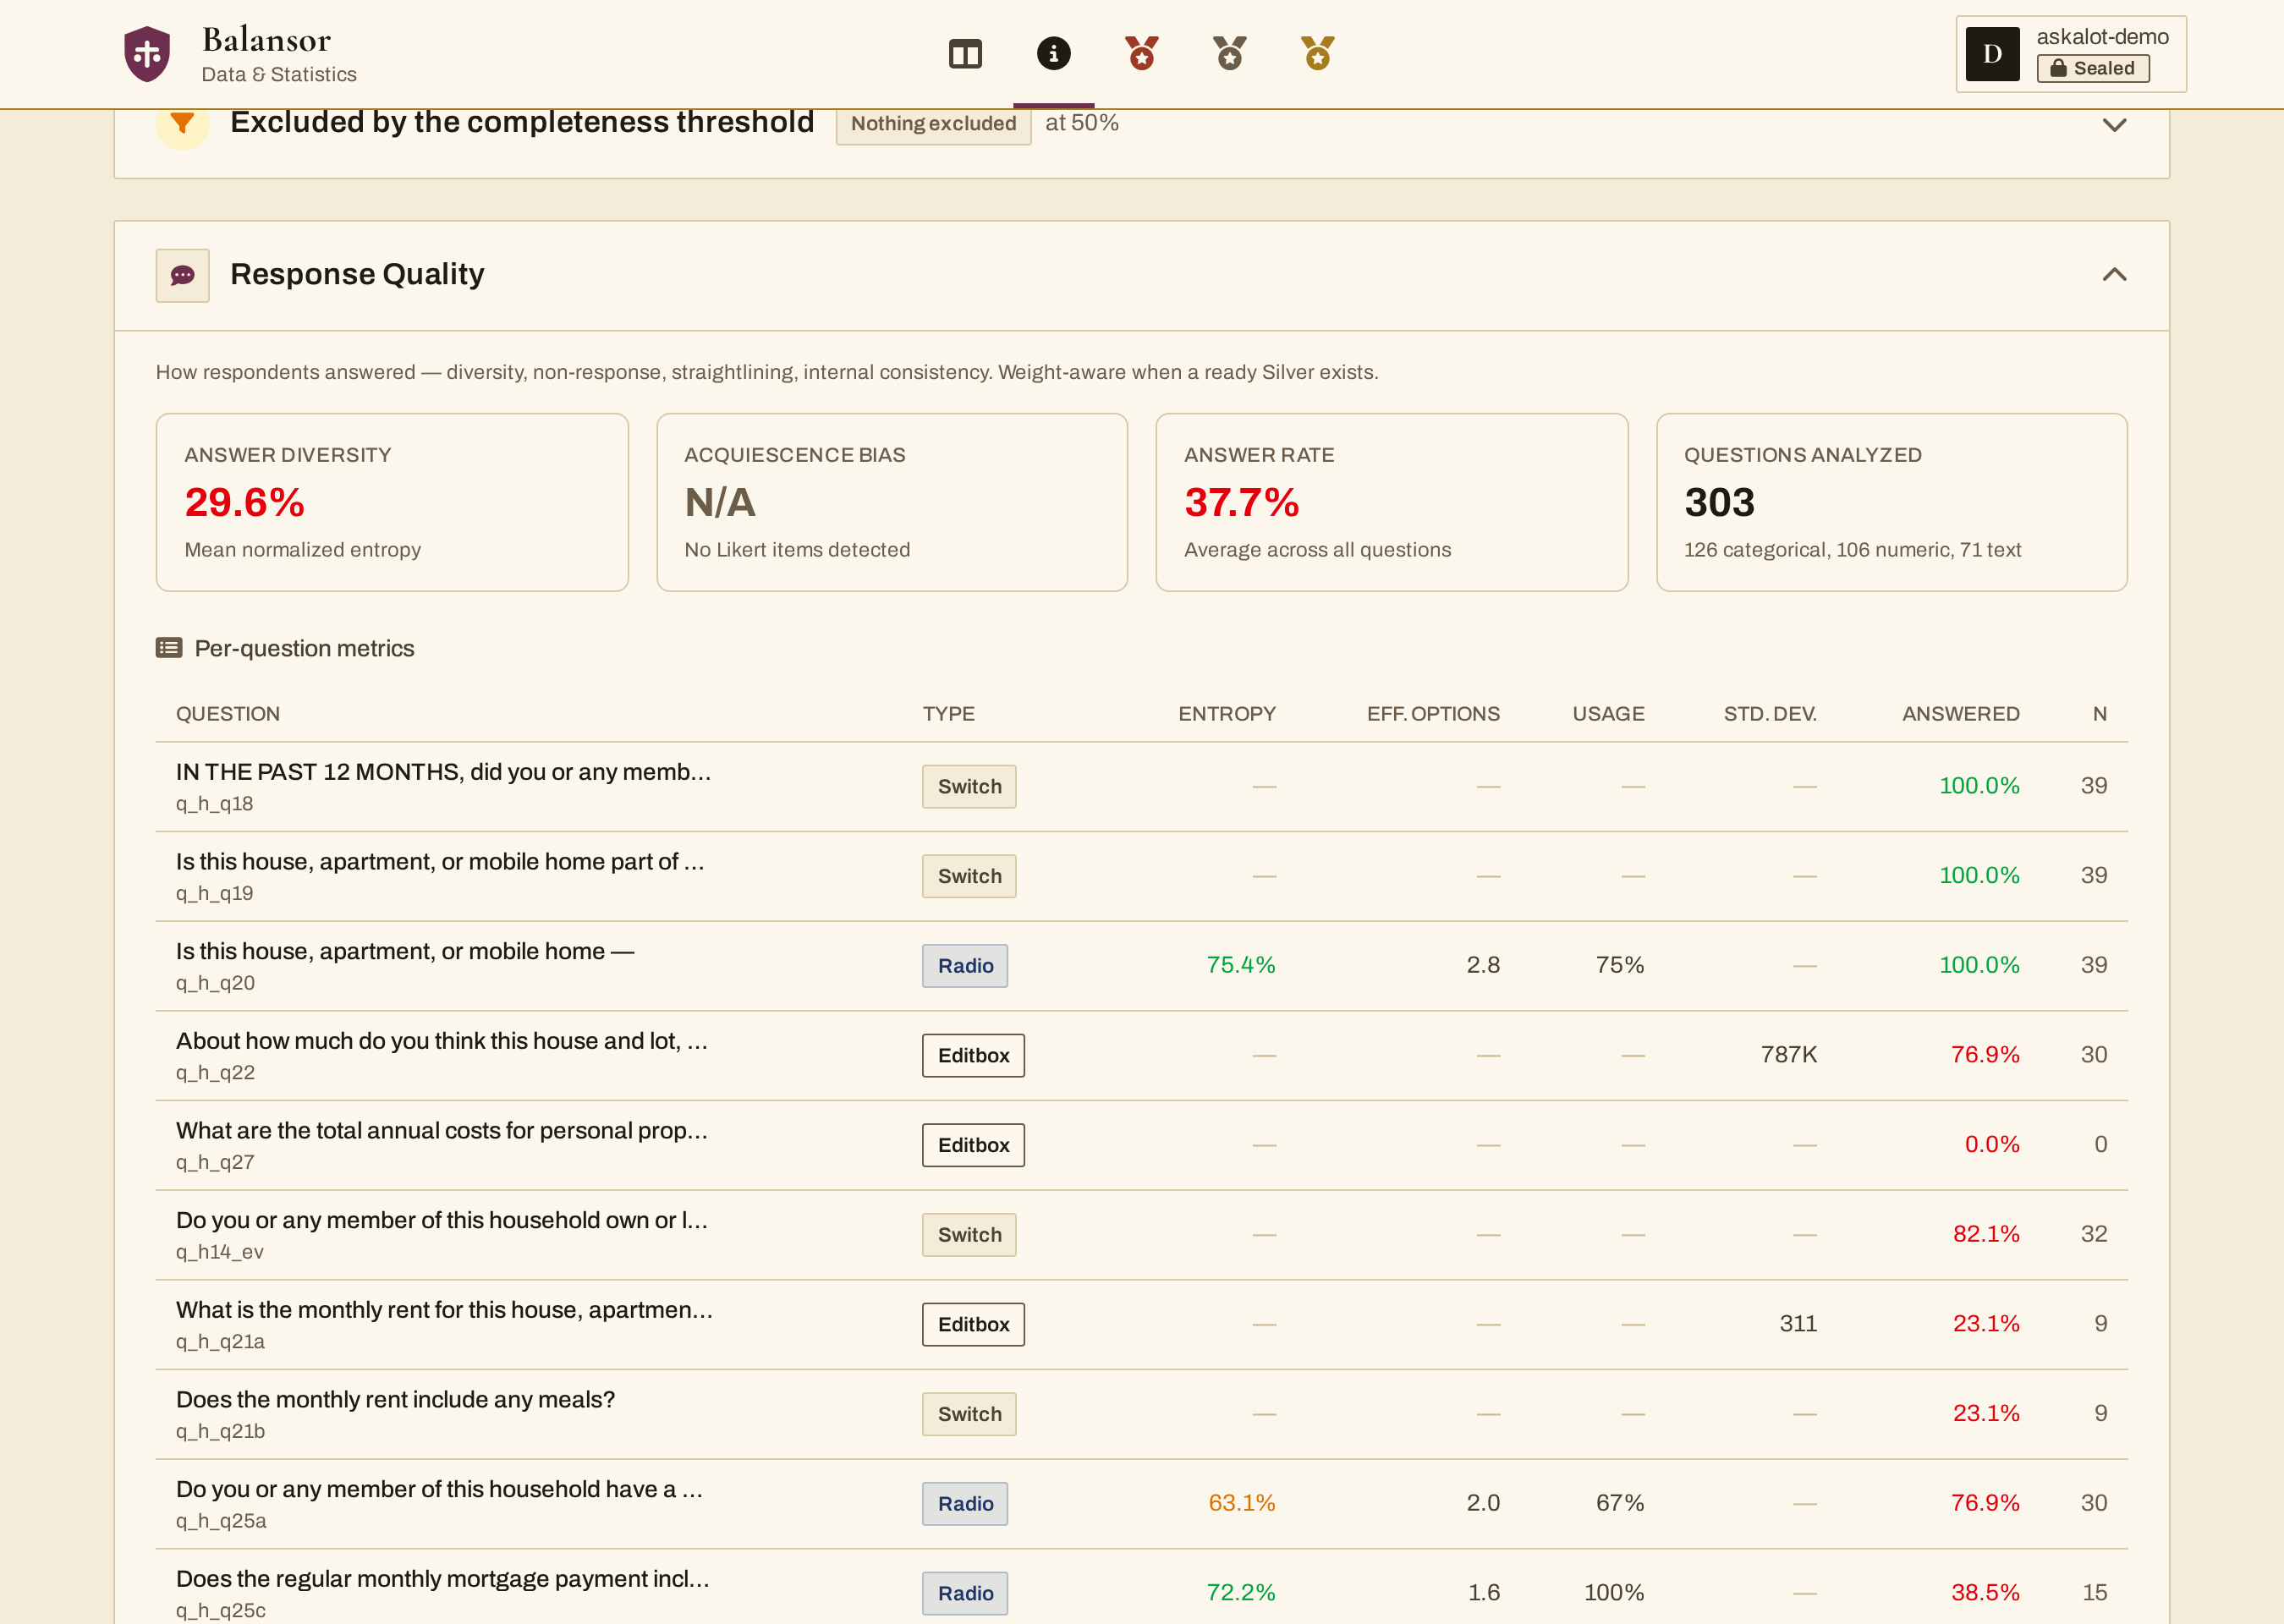
Der Abschnitt Antwortqualität eines Demo-Bundles: die vier Übersichtskarten über der Kennzahlentabelle pro Frage.
Er zeigt vier zusammenfassende Karten:
| Karte | Kennzahl | Bedeutung |
|---|---|---|
| Antwortvielfalt | Mittlere normierte Entropie | Durchschnittliche Antwortvielfalt über die kategorialen Fragen |
| Zustimmungstendenz | Bias-Index | Neigung zur Zustimmung bei Likert-Skalen; N/A, wenn der Fragebogen keine Likert-Items enthält |
| Antwortquote | Durchschnittlicher Antwortanteil | Anteil der Befragten, die eine Frage beantwortet haben, gemittelt über alle Fragen |
| Analysierte Fragen | Anzahl der Fragen | Zahl der analysierten Fragen nach Typ (kategorial, numerisch, Text) |
Unter der Zusammenfassung folgen eine Kennzahlentabelle pro Frage, ein Bereich zur Straightlining-Erkennung (für Gruppen), ein Bereich zur internen Konsistenz (Cronbachs Alpha für Gruppen mit mindestens 3 Unterfragen), die Ergebnisse der Speeder-Erkennung und die Aggregation von Befragten mit mehreren Auffälligkeiten.
KI-Analyse ausführen
Abschnitt betitelt „KI-Analyse ausführen“- Öffnen Sie die Übersichtsseite des Bundles (klicken Sie auf dem Pipeline-Board auf seinen Titel) und starten Sie dort im Bereich der KI-Analyse die Analyse
- Der Analyst-Agent startet im Hintergrund – Fortschrittsmeldungen erscheinen in Echtzeit
- Nach Abschluss erscheint der strukturierte Bericht mit methodisch fundierter Einordnung
Die Analyse liest den vollständigen Repräsentativitätsverlauf des Bundles – jedes Maß, die ausgeschlossenen Fälle, den Recovery-Wert und den Designeffekt –, sodass der Bericht genau das interpretiert, was Sie auf der Seite sehen. Sie setzt einen abgeleiteten Silver-Datensatz voraus (der Bericht wird am Silver-Datensatz gespeichert). Eine aktuelle Strategie ist nicht nötig: Der Verlauf enthält ausdrückliche Zustände keine Strategie, die der Analyst als solche ausweist, statt sie bei der Bewertung zu übergehen.
Die KI-Analyse benötigt:
- Einen API-Schlüssel für einen KI-Anbieter (hinterlegt im Benutzerprofil, in den Organisationseinstellungen oder in der Umgebung)
- Einen Portor-MCP-Endpunkt (für den Zugriff auf Qualitätstools und den Kampagnenkontext)
- Redis (für die workerübergreifende Fortschrittsverfolgung)
Detailseite eines Datensatzes
Abschnitt betitelt „Detailseite eines Datensatzes“Die Detailseite jedes Datensatzes nennt das zugehörige Bundle und verlinkt auf dessen Übersichtsseite, auf der der vollständige Repräsentativitätsverlauf und die KI-Analyse zu finden sind.
Ergebnisse interpretieren
Abschnitt betitelt „Ergebnisse interpretieren“Ausführliche Hinweise zur Interpretation – typische Muster, empfohlene Maßnahmen und die zweidimensionale Qualitätsmatrix – finden Sie in der Referenz der Qualitätskennzahlen: Ergebnisse interpretieren.
MCP-Tools
Abschnitt betitelt „MCP-Tools“Die Tools zur Qualitätsanalyse stehen über die MCP-Schnittstelle für programmatischen oder KI-gestützten Zugriff bereit:
| Tool | Zweck |
|---|---|
get_bundle_quality |
Der Repräsentativitätsverlauf des Bundles: Auswahl, Feldergebnis und Gewichtung (jeweils gemessen an der aktuellen Strategie), die auf den Pool bezogene Verschiebung durch die Feldphase, die Antwortqualität und was der Vollständigkeits-Schwellenwert ausgeschlossen hat |
compare_bundle_quality |
Bronze und Silver im Vergleich zur aktuellen Strategie des Bundles, mit dem Recovery-Wert – wie viel der Lücke zum Design die Gewichtung geschlossen hat |
Die vollständige Parameterdokumentation finden Sie in der Referenz der Bundle-Tools.
Weiterführende Dokumentation
Abschnitt betitelt „Weiterführende Dokumentation“- Referenz der Qualitätskennzahlen – Definitionen, Formeln und Interpretationsschwellen der Kennzahlen
- Leitfaden zur Datenanalyse – Bronze/Silver/Gold-Pipeline, Gewichtung, Export
- Kampagnenverwaltung – Stichprobenstrategien und Befragtenpools
- Agentenbasierte Antwortgenerierung – synthetische Daten zum Testen der Pipeline
- MCP-Bundle-Tools – programmatischer Zugriff auf den Qualitätsverlauf des Bundles